
Oui, à une condition : découper le travail avant de lancer le moindre agent. Sur une migration de design system, Orca m'a permis de faire tourner jusqu'à 10 agents dans 3 worktrees, sans un seul conflit de merge. Mais c'est la spec qui a fait le travail, pas l'outil.
À retenir
- Le zéro conflit vient du découpage en issues avec dépendances, pas de l'outil.
- Une journée de spec sur quatre, c'est ce qui a rendu le parallélisme possible.
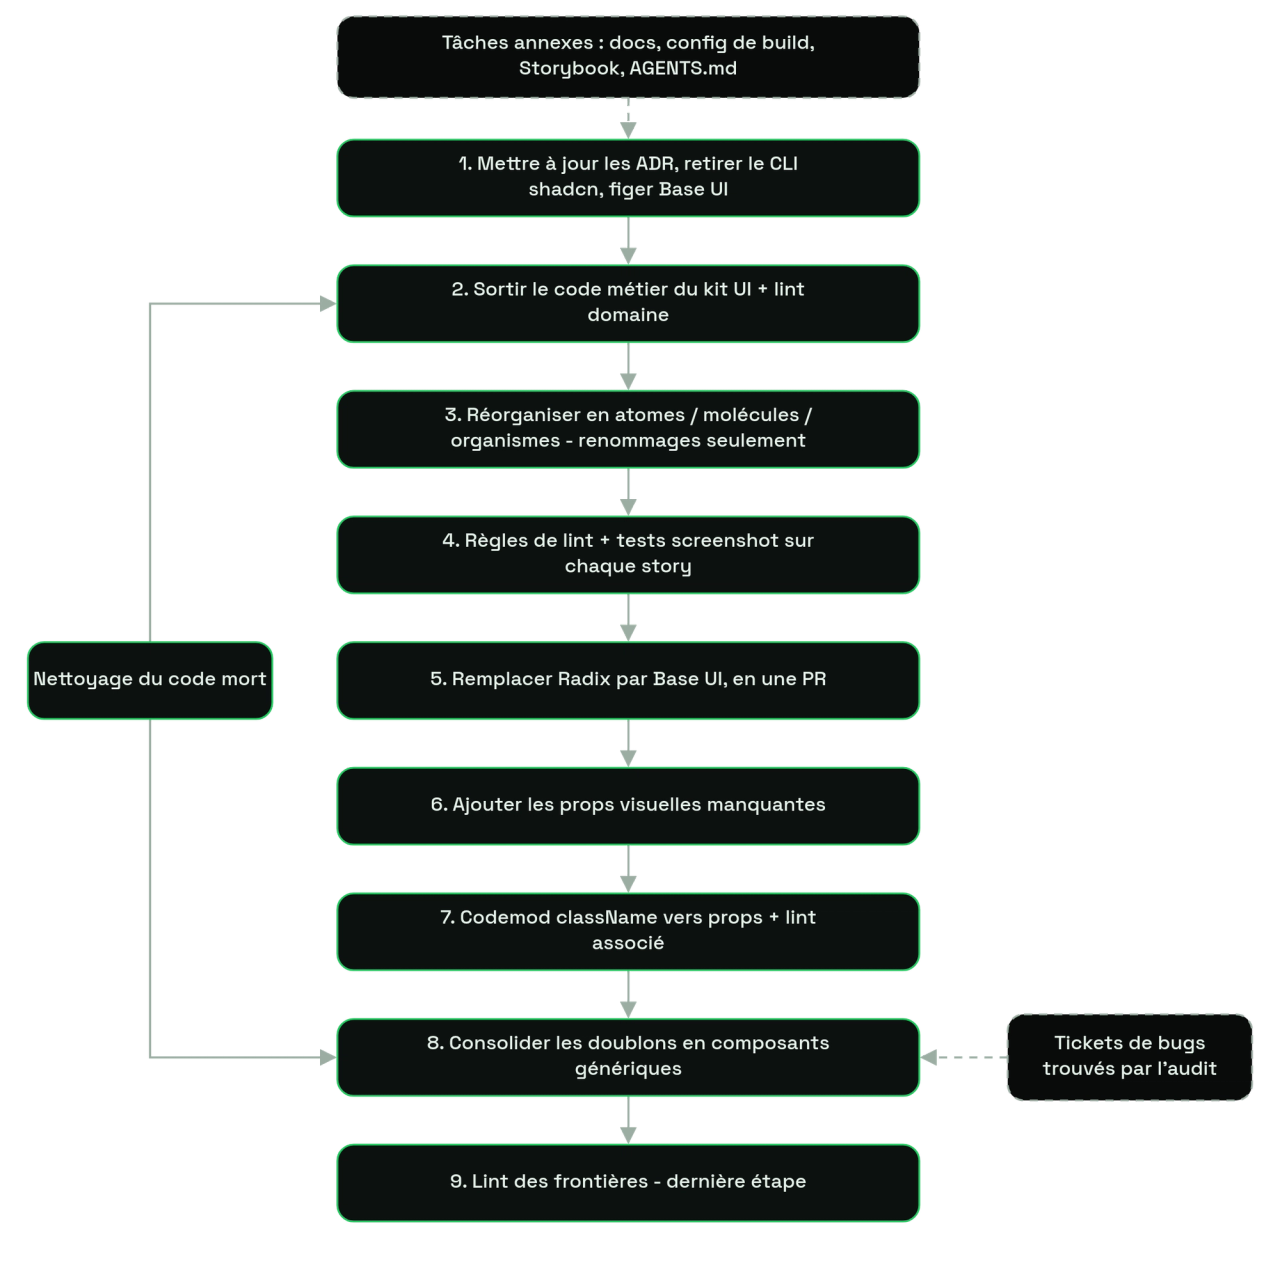
- Neuf étapes ordonnées forment la chaîne principale, le reste tourne à côté.
- Le parallélisme fait exploser la consommation de tokens : réserve les gros modèles aux issues difficiles.
- Un agent applique ta règle au pied de la lettre. Si la règle est floue, l'erreur se multiplie.
Le problème
Migrer le kit UI d'une app React (Radix et shadcn remplacés par Base UI, composants réorganisés en Atomic Design) touche une soixantaine de composants et une quinzaine de pages. Un seul agent avance trop lentement, et plusieurs agents dans des terminaux séparés deviennent impossibles à suivre. Comment répartir le travail entre plusieurs agents sans conflits ?
Étapes
Orca en deux mots
Orca est un environnement de développement pour agents, open source et sous licence MIT, développé par Stably AI. Il ne fait tourner aucun modèle lui-même : il pilote les agents en ligne de commande que tu utilises déjà (Claude Code, Codex, OpenCode…) avec tes propres abonnements. Chaque agent travaille dans son propre git worktree.
Un worktree, c'est un deuxième répertoire de travail rattaché au même dépôt Git, sur sa propre branche. Les deux répertoires partagent le même historique (le dossier .git), mais chacun a ses fichiers sur disque. Deux agents peuvent donc modifier le même fichier en même temps sans s'écraser: le conflit éventuel n'apparaît qu'au merge.
C'est exactement là que tout se joue. Orca isole les agents pendant qu'ils travaillent. Il ne t'évite pas les conflits au moment de réunir leur travail. Ça, c'est ton découpage qui s'en charge.
Le workflow, étape par étape
- Écrire la spec, puis la faire griller. Avant de lancer le moindre agent, j'ai rédigé une spec de la migration et je l'ai passée au skill grill-me de Matt Pocock. Le principe: l'agent t'interroge sur ton plan, une question à la fois, jusqu'à ce que chaque branche de décision soit tranchée. Cette étape m'a pris une journée entière sur les quatre du chantier.
- Découper la spec en issues Linear, avec des dépendances explicites. Chaque issue a un périmètre fermé et dit ce qu'elle bloque et ce qui la bloque. C'est ce graphe de dépendances qui décide de ce qui peut tourner en parallèle, pas l'envie d'aller vite.
- Isoler la chaîne principale. Neuf issues s'enchaînent dans un ordre strict. Elles ne se parallélisent pas, elles tournent l'une après l'autre (voir le schéma).
- Repérer ce qui tourne à côté. Tout ce qui n'est ni bloqué par la chaîne ni bloquant pour elle part dans un workspace Orca séparé: documentation, config de build, Storybook, fichier
AGENTS.md, nettoyage du code mort, tickets de bugs remontés par l'audit. - Donner l'issue comme prompt. Pas de prompt écrit à la main. Depuis l'onglet des tâches d'Orca, je donnais directement l'issue Linear, qui contenait déjà tout le contexte.
- Reviewer et merger issue par issue. Une issue terminée, une review, un merge. Puis on débloque la suivante.
Démo
Le point de départ
Une app Vite, React et TanStack Query, d'environ 60 composants et 15 pages, avec un kit UI construit sur Radix et shadcn. L'objectif : remplacer Radix par Base UI, ranger les composants en Atomic Design, nettoyer les design tokens et verrouiller le tout par du lint.
Base UI est une bibliothèque de composants React sans style, faite par des créateurs de Radix, Floating UI et Material UI, sortie en version 1 fin 2025. Son API est proche de celle de Radix, ce qui rend la migration envisageable, mais pas triviale: la composition passe par une prop render au lieu de asChild, et les attributs de style changent.
Le chantier commençait par un passage en monorepo Turborepo, avec pnpm à la place de Yarn. Le kit UI est devenu un package à part entière (packages/ui), ce qui permet ensuite de lui appliquer ses propres règles de lint. Le graphe ci-dessus démarre une fois ce socle en place.
Pourquoi cet ordre
L'ordre de la chaîne n'est pas arbitraire. Chaque étape prépare un filet de sécurité pour la suivante.
- Étape 2 avant tout le reste. Tant que du code métier vit dans le kit UI, le reclasser en atomes et molécules n'a pas de sens. On le sort d'abord, et un lint domaine empêche qu'il y revienne.
- Étape 3 : des renommages, rien d'autre. Déplacer et renommer sans toucher au comportement donne une PR facile à relire. Mélanger déplacement et refactor, c'est la garantie de rater quelque chose en review.
- Étape 4 avant la 5. Les tests screenshot sur chaque story Storybook photographient l'interface avant le changement de bibliothèque. Après le passage à Base UI, toute différence visuelle saute aux yeux.
- Étape 5 en une seule PR. Pas de période où Radix et Base UI cohabitent dans le kit.
- Étape 9 en dernier. Le lint des frontières entre couches ne peut passer au vert qu'une fois le code rangé. Activé trop tôt, il bloque tout.
Ce qui a tourné en parallèle
Pendant que la chaîne avançait, jusqu'à 3 workspaces Orca tournaient en même temps sur les issues annexes. À l'intérieur de chaque workspace, les skills Superpowers lançaient des sous-agents (implémentation, tests, recherche) : jusqu'à 10 agents actifs au total.
Le nettoyage du code mort montre bien l'intérêt du graphe. Il ne bloque pas l'étape 1, il peut donc démarrer dès le premier jour. Mais il doit être terminé avant les étapes 2 et 8, qui ont besoin d'un code sans branches mortes. Les tickets de bugs trouvés pendant l'audit, eux, alimentent l'étape 8.
L'issue, c'est le prompt
Je ne peux pas montrer les issues elles-mêmes, le dépôt est privé. Ce qui compte, c'est leur rôle: chaque issue portait assez de contexte pour qu'un agent puisse la traiter sans moi. Si tu dois réexpliquer une issue à l'agent, c'est qu'elle n'était pas prête à partir en parallèle.
Le lint qui verrouille les frontières
Le meilleur moyen d'empêcher un agent (ou un humain) de défaire l'architecture, c'est qu'il ne puisse pas. Voici la règle qui garantit que les bibliothèques de primitives ne sont importées que depuis les atomes du kit UI. Elle utilise no-restricted-imports, une règle native d'ESLint : tout import qui correspond à un des motifs de group lève une erreur, avec le message indiqué.
// Primitives libraries may be imported only from UI kit atoms (ADR 0003, ADR 0004 Enforcement).
// Applies everywhere; packages/ui/eslint.config.js switches it off for src/atoms/**.
// A stopgap the eslint-plugin-boundaries allow-matrix may replace.
export default {
    name: 'kit/primitives-only-from-atoms',
    files: ['**/*.{ts,tsx}'],
    rules: {
        'no-restricted-imports': [
            'error',
            {
                patterns: [
                    {
                        group: [
                            '@base-ui/react',
                            '@base-ui/react/*',
                            '@radix-ui/*',
                            'react-day-picker',
                            'react-day-picker/*',
                            'recharts',
                            'recharts/*',
                            'input-otp',
                            'input-otp/*',
                        ],
                        message:
                            'Primitives libraries may be imported only from UI kit atoms (ADR 0003). Use or add an atom in packages/ui/src/atoms.',
                    },
                ],
            },
        ],
    },
}
Trois détails à retenir :
- La règle s'applique partout, sauf dans les atomes. C'est la config ESLint de
packages/uiqui la désactive poursrc/atoms/**. Les atomes deviennent le seul point d'entrée vers Base UI. @radix-ui/*reste dans la liste après la migration. Si un agent réintroduit Radix par habitude, le lint casse immédiatement.- Le message dit quoi faire, pas seulement ce qui est interdit. Un agent qui lit « utilise ou ajoute un atome dans packages/ui/src/atoms » se corrige tout seul.
C'est une solution provisoire, et elle le dit dans son commentaire : eslint-plugin-boundaries permet de décrire une matrice complète de qui a le droit d'importer qui (atomes, molécules, organismes, pages), là où cette règle ne couvre qu'une seule frontière.
Le résultat
Quatre jours au total, dont un de spec. À la fin : Radix et shadcn remplacés par Base UI, les composants rangés en Atomic Design, les design tokens nettoyés, des tests screenshot sur chaque story, les frontières lintées, et aucun conflit de merge sur toute la migration.
Ce qui m'a vraiment servi dans Orca
- Savoir qui a fini. Avec plusieurs agents dans des terminaux séparés, le vrai problème n'est pas de les lancer, c'est de savoir lequel attend une review. Orca centralise cet état.
- L'application mobile. Une notification quand un agent termine, et je peux débloquer l'issue suivante sans rester devant l'écran.
- Les workspaces avec changement de compte. Pratique quand un abonnement arrive à ses limites (voir plus bas).
Je n'ai pas utilisé les artefacts ni le partage de skills d'Orca. Je ne peux donc pas en parler.
Limites
- Les tokens partent très vite. Avec plusieurs agents en parallèle, j'ai atteint les limites d'un abonnement Claude Max x5 en moins d'une heure. La solution : réserver les modèles les plus puissants aux issues difficiles, et passer sur des modèles moins chers pour les tâches simples, comme corriger un package.json.
- Les agents suivent la règle, pas l'intention. Ma spec définissait un atome à partir de ses imports. Un agent a appliqué la règle au pied de la lettre et a classé comme atome tout composant qui n'importait qu'un seul autre composant, y compris un menu déroulant composé de plusieurs éléments. Or en Atomic Design, un atome est un élément d'interface qu'on ne peut plus décomposer, comme un bouton ou un champ. Un menu déroulant est au minimum une molécule. Le problème n'était pas l'agent, c'était une définition qui confondait un critère technique (le nombre d'imports) avec le concept.
- Le parallélisme multiplie aussi les erreurs. Cette erreur ne venait pas du parallélisme : chaque agent avait un type de tâche différent. Mais une règle mal écrite, appliquée par plusieurs agents en même temps et relue par des tests rapides à la main, c'est la même erreur reproduite partout, et la facture de tokens qui va avec.
- La chaîne principale ne va pas plus vite. Neuf étapes séquentielles restent neuf étapes séquentielles. Orca accélère tout ce qui est autour, pas le cœur du chantier.
Verdict
Tester : À tester une fois que tu sais découper une spec et relire une PR. Avant, tu parallélises tes erreurs.
Questions fréquentes
Orca est-il payant ?
- Non, Orca est gratuit et open source, sous licence MIT. En revanche, il utilise tes propres abonnements aux agents (Claude Code, Codex…), et faire tourner plusieurs agents en parallèle consomme ces abonnements beaucoup plus vite.
Quelle différence avec plusieurs terminaux et des git worktrees créés à la main ?
- Techniquement, la même isolation. La différence est dans le suivi: Orca te montre quel agent a fini, lequel attend une review, et te notifie sur mobile. Sans ça, tu passes ton temps à vérifier chaque terminal.
Combien d'agents lancer pour commencer ?
- Deux suffisent : un sur la tâche principale, un sur une tâche annexe qui ne touche aucun des mêmes fichiers. Monte seulement quand tu arrives à relire tout ce qu'ils produisent.